
Priprava podatkov za AI: vodnik po korakih za podjetja
Priprava podatkov za AI: vodnik po korakih za podjetja
Priprava podatkov za AI pomeni, da podatke, ki jih podjetje že ima v ERP, MES, CRM, e-pošti in dokumentih, izberete, očistite, poenotite, označite in povežete. Le tako jih umetna inteligenca lahko zanesljivo bere in iz njih napoveduje. To ni stranska naloga pred projektom, temveč njegov najpomembnejši del: model nad napačnimi podatki ne more dati dobrega rezultata. V nadaljevanju so postopek v sedmih korakih, merila kakovosti, pravila varstva podatkov v Sloveniji in EU ter napake, ki jih najpogosteje vidimo v proizvodnji, logistiki in distribuciji.
Novacore-groupPodatki za učinkovitejše proceseNovaCore Group avtomatizira delovne procese z umetno inteligenco ter pomaga podjetjem optimizirati upravljanje dokumentov, proizvodnjo in načrtovanje.Spoznajte rešitveNa kratko
- Začnite pri enem konkretnem procesu (npr. obdelava naročil ali planiranje proizvodnje) in šele nato določite, katere podatke potrebujete.
- Priprava zajema zbiranje, raziskovanje, čiščenje, pripravo značilnic, integracijo in preverjanje kakovosti. Po slovenski strokovni literaturi je to časovno najzahtevnejši del projekta.
- Kakovost merite po jasnih merilih: natančnost, popolnost, konsistentnost, edinstvenost in ažurnost.
- Strokovnjaki iz proizvodnje ali logistike morajo sodelovati od prvega dne, sicer podatki ne bodo pravilno označeni.
- Osebni podatki in poslovne skrivnosti potrebujejo jasna pravila dostopa že pred prvim zagonom, v skladu s Splošno uredbo in ZVOP-2.
Kazalo
- Zakaj o uspehu AI odločajo podatki
- Katere podatke potrebujete za svoj primer uporabe
- Priprava podatkov v sedmih korakih
- Kako preverite, ali so podatki dovolj kakovostni
- Varstvo osebnih in zaupnih podatkov
- Najpogostejše napake in kako se jim izognete
- Naš pogled: podatke pripravljamo za proces, ne za model
- Kako vam pomagamo pri uvedbi
- Pogosta vprašanja
- Viri
Zakaj o uspehu AI odločajo podatki
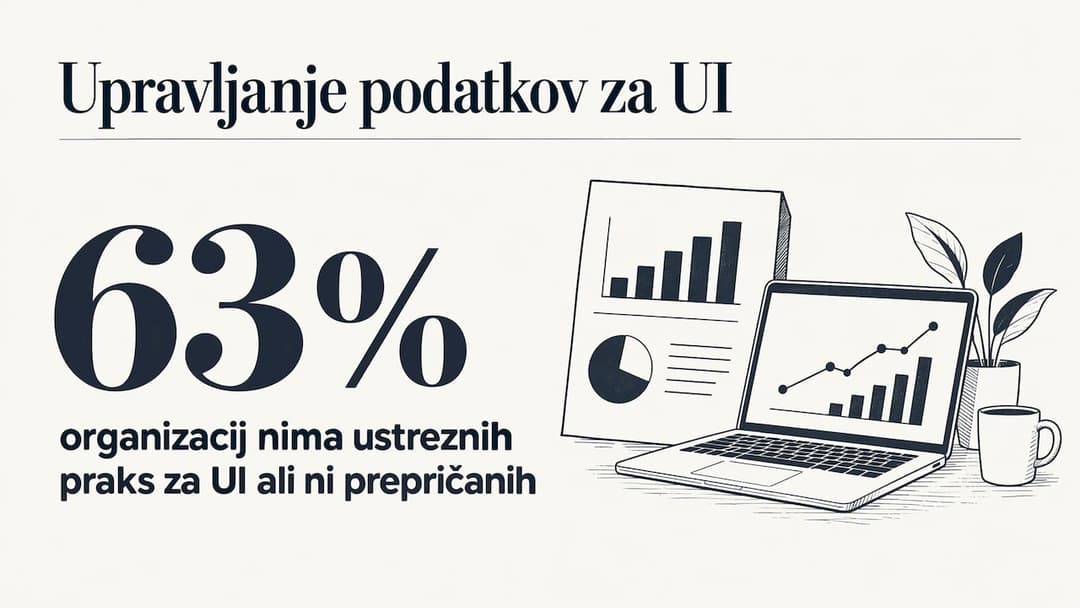
Algoritmi so danes dostopni skoraj vsem. Razliko med projektom, ki prinese merljiv učinek, in projektom, ki obstane v pilotni fazi, pogosto naredijo podatki. Gartnerjeva raziskava med 1.203 vodji upravljanja podatkov je pokazala, da 63 % organizacij nima ustreznih praks upravljanja podatkov za umetno inteligenco ali v to ni prepričanih.
Slovenski strokovni vir, ki opisuje proces CRISP-DM, je pri tem jasen: priprava in predobdelava podatkov je časovno najzahtevnejše, a najpomembnejše opravilo celotnega procesa, saj inteligentna rešitev nad neustreznimi podatki ne more dati dobrega rezultata. Tudi vodič GZS za uvajanje UI v mala in srednja podjetja pripravi podatkov namenja samostojen korak v postopku uvedbe.
V praksi se to kaže zelo konkretno. Isti kupec je v CRM vpisan trikrat z različnimi naslovi. Šifre artiklov v ERP se ne ujemajo s šiframi na dobavnicah dobavitelja. Časi zastojev na liniji so zabeleženi ročno, enkrat v minutah, drugič v urah. Članek na Financah navaja prav podvojene evidence o istem kupcu v CRM kot eno najpogostejših težav. Ko te stvari uredite, AI dobi trdno podlago in rezultati postanejo ponovljivi.
Če še niste prepričani, kje je vaše podjetje, vam pri tem pomaga naša ocena zrelosti za umetno inteligenco.
Katere podatke potrebujete za svoj primer uporabe
Pravilni vrstni red je: najprej proces in cilj, nato podatki. Vprašanje »kaj nas trenutno stane preveč časa ali napak« vas do pravih virov pripelje hitreje kot popis vseh tabel v podjetju.
| Primer uporabe | Ključni viri podatkov | Na kaj posebej pazite |
|---|---|---|
| Avtomatizacija dokumentov (naročila, računi, dobavnice) | PDF-ji in skeni, e-pošta, šifranti artiklov in partnerjev v ERP | Enotni šifranti, primeri vseh oblik dokumentov, tudi redkih |
| Planiranje in razporejanje proizvodnje | Delovni nalogi, kosovnice, tehnološki postopki, kapacitete strojev, podatki iz MES | Realni časi operacij namesto normativov, zabeleženi zastoji |
| Logistika in obdelava naročil | Naročila, transportni nalogi, podatki o dostavah, naslovi | Pravilni in poenoteni naslovi, časovni žigi dogodkov |
| Napovedovanje povpraševanja | Zgodovina prodaje, akcije, sezonskost, odpovedana naročila | Dovolj dolga zgodovina, označene izjeme (akcije, izpadi zalog) |
| Živilska industrija in distribucija | Serije oz. loti, roki uporabnosti, temperature, vračila | Povezava med serijo, prevzemom in odpremo za sledljivost |
Za vsak vir zapišite tri stvari: kje podatki nastajajo, kdo je zanje odgovoren in kako pogosto se osvežujejo. Ta preprost popis kasneje prihrani tedne iskanja.
Priprava podatkov v sedmih korakih
Spodnji koraki sledijo uveljavljenemu procesu CRISP-DM in naši izkušnji z uvedbami v proizvodnji, logistiki in farmaciji.
1. Določite cilj in merilo uspeha
Opredelite en proces in eno številko, ki jo želite izboljšati: čas obdelave naročila, delež napak pri vnosu, natančnost napovedi ali izkoriščenost linije. Brez merila ne veste, kateri podatki so pomembni in kdaj so »dovolj dobri«.
2. Popišite in zberite vire
Določite nabor potrebnih podatkov in jih zberite. Kadar vira še ni, ga vzpostavite: na primer začnete beležiti razloge za zastoje ali shranjevati izvirne PDF-je naročil skupaj z vnosom v ERP. Več o tem, kako AI povezati z obstoječim poslovnim sistemom, najdete v vodniku integracija AI z ERP.
3. Raziščite podatke
Preden karkoli spreminjate, si podatke oglejte: porazdelitve, manjkajoče vrednosti, nenavadne skoke, obdobja brez zapisov. Pogosto se že tu pokaže, da je v določenem mesecu prišlo do menjave sistema ali spremembe šifranta.
4. Očistite in standardizirajte
To je jedro dela:
- odstranite ali združite dvojnike (isti kupec, isti artikel pod različnimi šiframi),
- poenotite enote, formate datumov, decimalna ločila in zapis naslovov,
- določite pravila za manjkajoče vrednosti (dopolnitev, izločitev ali posebna oznaka),
- popravite očitne napake vnosa in zabeležite, kaj ste spremenili.
5. Označite podatke s pomočjo strokovnjakov
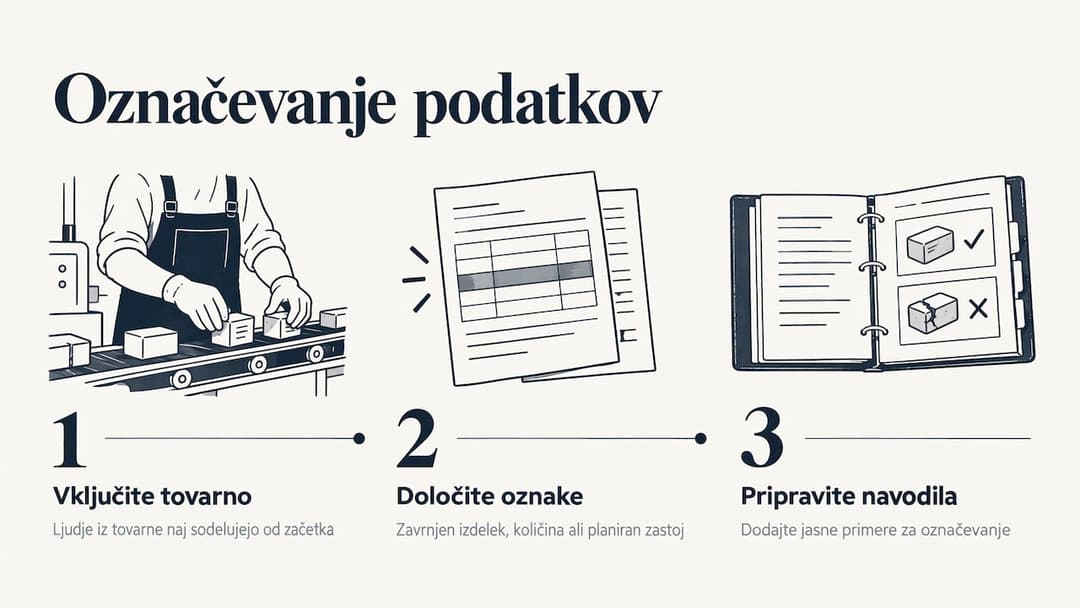
Za učenje modela potrebujete pravilne oznake: kateri izdelek je bil zavrnjen in zakaj, katera vrstica na dokumentu je količina, kateri zastoj je bil planiran. Strokovnjaki, ki jih navaja portal CTOP, poudarjajo, da morajo biti ljudje iz tovarne vključeni od začetka, saj podatkovni inženir brez poznavanja procesa ne loči nepomembne praske od kritične napake. Pripravite pisna navodila za označevanje z jasnimi primeri.
6. Pripravite značilnice in povežite vire
Iz surovih podatkov izpeljite spremenljivke, ki imajo za model pomen: dan v tednu, čas od zadnjega servisa, povprečna zamuda dobavitelja. Nato podatke iz različnih sistemov zlijete prek skupnih ključev (šifra artikla, številka naloga, serija). Pri večjih količinah se splača razmisliti o arhitekturi shranjevanja; razlike pojasnjujemo v članku data lake ali data warehouse.
7. Preverite kakovost in dokumentirajte izvor
Pred učenjem pripravljen nabor preverite po merilih v naslednjem razdelku. Hkrati vodite zapis, od kod podatek prihaja in kam se je prenesel. Finance.si opozarjajo, da morate ob odkritju napačnega ali pristranskega podatka vedeti, od kod prihaja in v katere druge zbirke se je razširil.
Kako preverite, ali so podatki dovolj kakovostni
Kakovost ni občutek, temveč nabor preverljivih meril. Priročnik o odprti znanosti navaja vidike, ki jih lahko neposredno prenesete v podjetje:
| Merilo | Vprašanje za vaše podatke | Primer iz prakse |
|---|---|---|
| Veljavnost | So podatki primerni za namen in niso zastareli? | Cenik iz preteklega leta ne sme vplivati na napoved marž |
| Natančnost | So vrednosti pravilne? | Količina na naročilu se ujema z vnosom v ERP |
| Popolnost | Imate vse potrebne podatke? | Vsak delovni nalog ima začetni in končni čas |
| Konsistentnost | Ni nasprotujočih si zapisov? | Isti artikel nima dveh različnih mer |
| Usklajenost | So podatki enotni med sistemi? | Šifra kupca je enaka v CRM, ERP in logistiki |
| Edinstvenost | Ali je vsak zapis le enkrat? | Brez podvojenih partnerjev in naročil |
| Celovitost | So razmerja med podatki pravilna? | Vsaka odprema je vezana na obstoječe naročilo |
| Jasnost | Razume opise polj tudi nekdo zunaj oddelka? | Opisan pomen statusov naloga |
Pri označenih podatkih dodajte še ročni pregled naključnega vzorca: strokovnjak preveri, ali so oznake pravilne. Po uvedbi kakovost spremljajte stalno, saj se procesi, dobavitelji in šifranti spreminjajo. Ko se natančnost napovedi spremeni, najprej preverite podatke; pri iskanju vzroka si lahko pomagate z metodami iz članka RCA analiza napak.
Varstvo osebnih in zaupnih podatkov
Priprava podatkov je tudi trenutek, ko odločite, česa AI ne sme videti.
Splošna uredba in ZVOP-2. Splošna uredba je tehnološko nevtralna. Informacijski pooblaščenec poudarja, da mora vsaka obdelava osebnih podatkov v sistemih UI izpolnjevati vse zahteve Splošne uredbe in ZVOP-2, enako kot obdelava z drugimi orodji. Podatke smete obdelovati za opredeljen in zakonit namen in le v obsegu, ki je za ta namen potreben. Kadar obdelava pomeni veliko tveganje za posameznike, je potrebna ocena učinka.
Varnost podatkov. Po smernicah Evropskega odbora za varstvo podatkov varnost pomeni zaščito zaupnosti, celovitosti in razpoložljivosti, zaposleni, ki podatke obdelujejo, pa morajo poznati tveganja in ukrepe. ZVOP-2 v 23. členu določa posebne zahteve za sisteme, v katerih se na podlagi zakona obdelujejo podatki več kot 100.000 posameznikov ali posebne vrste podatkov več kot 10.000 posameznikov.
Pooblaščena oseba in evidence. Po povzetku Splošne uredbe na EUR-Lex morajo podjetja, ki podatke obdelujejo v velikem obsegu ali katerih temeljna dejavnost je obdelava posebnih vrst podatkov, imenovati pooblaščeno osebo za varstvo podatkov.
V praksi pred začetkom pripravite seznam kategorij: osebni podatki zaposlenih in kupcev, poslovne skrivnosti, finančni podatki. Za vsako kategorijo določite, ali jo AI sme uporabljati, v kakšni obliki (npr. psevdonimizirano) in kdo ima dostop. Pregled poti, po katerih podatki uhajajo iz sistemov AI, vam pomaga postaviti tehnične omejitve. Pri odločitvi, kje bodo tekli podatki in modeli, preberite še naša vodnika on-premise ali oblak za AI in zasebni LLM v podjetju.
Če boste obdelovali podatke zaposlenih ali posebne vrste osebnih podatkov, oceno učinka in pravno podlago pred zagonom preverite s svojo pooblaščeno osebo za varstvo podatkov ali s pravnikom, specializiranim za varstvo podatkov.
Akt o umetni inteligenci. Za visoko tvegane sisteme UI evropski Akt o umetni inteligenci v 10. členu o podatkih in upravljanju podatkov zahteva kakovostne učne, validacijske in testne nabore ter ustrezne prakse upravljanja podatkov. Tudi če vaš primer ni visoko tvegan, so te prakse dobro izhodišče.
Najpogostejše napake in kako se jim izognete
- Začetek s tehnologijo namesto s procesom. Rešitev: najprej proces in merilo uspeha, nato izbor podatkov.
- Nejasna navodila za označevanje. Raziskava o kakovosti označevanja med pogostimi težavami navaja ravno nejasna navodila in zanemarjene robne primere. Rešitev: pisna navodila s primeri in redni pregled vzorca.
- Strokovnjaki iz procesa ostanejo zunaj. Planer, vodja izmene ali disponent ve, kateri zapisi so izjeme. Vključite jih od prvega sestanka.
- Ročno čiščenje brez zapisa. Enkratno popravljanje v Excelu se ne ponovi, ko pridejo novi podatki. Pravila čiščenja avtomatizirajte v podatkovnem toku.
- Odločanje brez razlage. Japonski inštitut AISI v svojem priročniku o kakovosti podatkov poudarja, da sistemi UI ne smejo delovati kot »črna skrinjica«. Za uporabnike v podjetju pripravite razlago, na čem temelji predlog sistema; pri tem vam pomaga okvir za upravljanje umetne inteligence v petih fazah.
- Pozabljeno vzdrževanje. Podatki se starajo. Določite lastnika podatkov in pregled kakovosti vsaj ob vsaki spremembi procesa ali sistema.
Naš pogled: podatke pripravljamo za proces, ne za model
Ko vstopimo v projekt, najprej ne vprašamo, koliko podatkov ima podjetje, ampak kateri proces ga stane največ. Šele potem gremo v ERP, MES in dokumente ter skupaj s planerji, operaterji in vodji določimo, kateri podatki so zares pomembni.
Zato pri nas na projektu dela več strokovno specializiranih ekip. Ekipa, ki pozna proizvodnjo, ve, kaj pomeni zastoj na liniji. Ekipa, ki pozna logistiko, ve, zakaj se naslov dostave ne ujema z naslovom kupca. Ta panožna poglobljenost je razlog, da so podatki pravilno označeni že prvič.
Podatkov ne pripravljamo enkrat za vselej. Ko je rešitev v produkciji, ostanemo ob vas in skrbimo, da sistem dobiva urejene podatke tudi, ko se spremenijo šifranti, dobavitelji ali procesi. Rezultati so merljivi: pri eni od naših uvedb se je čas obdelave naročil skrajšal za 68 %, naložba pa se je povrnila v 8 do 10 mesecih.
Martin
Kako vam pomagamo pri uvedbi
V NovaCore Group gradimo AI rešitve, ki tečejo nad vašimi obstoječimi sistemi: avtomatizacijo dokumentov (AI zajem, klasifikacija, preverjanje in prenos v ERP), upravljanje proizvodnje in logistike ter prediktivno planiranje s povezavo na ERP in MES, napovedovanjem povpraševanja in odkrivanjem ozkih grl.
Za farmacijo in betonske obrate imamo tudi končna produkta, Vilintra in Concreete. Rešitev prilagodimo vašim procesom in vas po uvedbi stalno podpiramo.
→ Oglejte si naše rešitve ali projekte v produkciji in nam pišite, kateri proces želite pospešiti.
Pogosta vprašanja
Koliko podatkov potrebujem za začetek?
Odvisno od primera uporabe, a pomembnejši od količine sta kakovost in pokritost. Za napovedovanje povpraševanja potrebujete zgodovino, ki zajema več sezon, za zajem dokumentov pa primere vseh oblik dokumentov, ki jih prejemate. Strokovnjaki s CTOP poudarjajo, da pri UI v proizvodnji ne gre samo za količino, ampak tudi za kakovost podatkov.
Koliko časa traja priprava podatkov?
Priprava je praviloma časovno najzahtevnejši del projekta. Trajanje je odvisno od števila virov, stanja šifrantov in razpoložljivosti strokovnjakov za označevanje. Če začnete z enim procesom in jasnim merilom, prve rezultate vidite hitreje.
Ali moram pred uvedbo AI urediti vse podatke v podjetju?
Ne. Uredite podatke, ki jih potrebuje izbrani proces, in jih vzdržujte. Z vsakim naslednjim primerom uporabe se nabor urejenih podatkov širi.
Ali smem za AI uporabiti osebne podatke kupcev in zaposlenih?
Da, če imate pravno podlago, jasno opredeljen namen in obdelujete le potreben obseg podatkov, kot zahtevata Splošna uredba in ZVOP-2. Pri visokem tveganju za posameznike je potrebna ocena učinka. Podrobnosti preverite s pooblaščeno osebo za varstvo podatkov.
Kdo v podjetju naj sodeluje pri pripravi podatkov?
Lastnik procesa, ljudje, ki podatke vsak dan uporabljajo (planerji, operaterji, disponenti), skrbnik ERP ali MES in oseba, odgovorna za varstvo podatkov. Brez strokovnjakov iz procesa oznake ne bodo pravilne.
Viri
- Gartner: Lack of AI-Ready Data Puts AI Projects at Risk
- dLib: proces CRISP-DM in priprava podatkov
- GZS AI4SI: Vodič uvajanja UI v MSP
- Finance.si: Slabi podatki lahko pokvarijo tudi najboljšo umetno inteligenco
- CTOP: Pri proizvodnji s pomočjo UI ne gre samo za količino, ampak tudi za kakovost podatkov
- Priročnik o odprti znanosti: Ocena kakovosti in uporabnosti podatkov
- IPRS: mnenje o obdelavi osebnih podatkov in UI
- IPRS: Varnost osebnih podatkov
- Your Europe: Varstvo podatkov v okviru splošne uredbe
- EDPB: Zavarujte osebne podatke
- EUR-Lex: Povzetek Splošne uredbe o varstvu podatkov
- AI Act Service Desk: 10. člen, podatki in upravljanje podatkov
- arXiv: Data Annotation Quality Problems in AI-Enabled Perception
- AISI: Data Quality Management Guidebook