
Zasebni LLM v podjetju: kdaj se splača in kako ga uvesti
Zasebni LLM v podjetju: kdaj se splača in kako ga uvesti
Zasebni LLM je velik jezikovni model, ki teče na vaši infrastrukturi ali v okolju, ki ga nadzorujete sami: na lastnem strežniku, v podatkovnem centru ali v namenskem zasebnem oblaku. Pogodbe, naročila, reklamacije in proizvodni podatki tako ne potujejo k zunanjemu ponudniku klepetalnika. Za slovenska podjetja je to danes realna možnost, ne eksperiment. Odločitev pa ni samo tehnična: odvisna je od tega, katere podatke boste obdelovali, koliko ljudi bo model uporabljalo hkrati, kdo ga bo vzdrževal in kateri poslovni proces mora z njim postati hitrejši. V nadaljevanju razložimo, kaj zasebni model zahteva, koliko dela je za njim in kje prinese merljiv rezultat.
Novacore-groupnovacore-group.siPovežite zasebni LLM z delovnimi procesiNovaCore Group avtomatizira delovne procese z umetno inteligenco, tudi pri upravljanju dokumentov, proizvodnji in načrtovanju.Raziščite rešitve NovaCoreNa kratko
- Zasebni LLM pomeni, da model, podatki in dnevniki ostanejo v okolju, ki ga nadzoruje podjetje, bodisi na lastni strojni opremi (on-prem) bodisi v namenskem zasebnem oblaku.
- Odprti modeli danes zadoščajo za večino ozkih poslovnih nalog: zajem podatkov iz dokumentov, klasifikacijo, povzemanje in iskanje po internem znanju.
- Strojno opremo dimenzionirate po številu sočasnih uporabnikov, ne le po velikosti modela, saj vsak dodaten uporabnik porabi pomnilnik grafične kartice.
- Največje tveganje ni strežnik, temveč manjkajoča ekipa za upravljanje modela, varnost in povezavo s sistemi, kot sta ERP in MES.
- Vrednost nastane šele, ko model postane del procesa, na primer obdelave naročil, in ne ostane samostojen klepetalnik.
Kazalo
- Kaj točno pomeni zasebni jezikovni model
- Zakaj se slovenska podjetja odločajo za lasten model
- Pravni okvir: GDPR, AI Act in odgovornost podjetja
- Kaj potrebujete za delujoč zasebni LLM
- Uvedba v šestih korakih
- Kje zasebni model prinese največ
- Naš pogled: model je orodje, proces je cilj
- Avtomatizacija z AI, ki deluje v vaših sistemih
- Pogosta vprašanja
- Viri
Kaj točno pomeni zasebni jezikovni model
Izraz se uporablja ohlapno, zato ga najprej razčlenimo. Ko podjetja govorijo o zasebnem LLM, imajo običajno v mislih eno od treh postavitev. Vse tri temeljijo na isti ideji: model obdeluje vaše podatke, vi pa nadzorujete, kje se to zgodi in kdo ima dostop.
| Postavitev | Kje teče model | Nadzor nad podatki | Začetna naložba | Primerno za |
|---|---|---|---|---|
| Lokalno (on-prem) | Lastni strežnik v podjetju ali najetem prostoru v podatkovnem centru | Popoln, podatki ne zapustijo omrežja | Visoka, nakup strojne opreme | Občutljive podatke, stroge interne politike, stalno visoko obremenitev |
| Namenski zasebni oblak | Najeti grafični strežniki, izolirani samo za vas | Visok, odvisen od pogodbe in lokacije strežnikov | Srednja, plačilo po porabi ali mesečno | Hitrejši začetek, pilotne projekte, nihajočo obremenitev |
| Javni API z zaščitami | Model ponudnika, dostop prek vmesnika | Omejen, odvisen od pogojev ponudnika | Nizka | Nezaupne naloge, preizkušanje idej |
Angleški izrazi, ki jih boste srečali, so “self-hosted LLM” (model, ki ga gostite sami, ne glede na to, kje stoji strežnik) in “LLM on-prem” (model na strojni opremi v lastnih prostorih). V praksi ločnica ni ostra. Pogost vzorec je hibrid: pilot v zasebnem oblaku, produkcija na lastnem strežniku, ko je obremenitev znana.
Zasebni model ni isto kot učenje lastnega modela
Pogosta napačna predstava je, da mora podjetje model naučiti od začetka. To skoraj nikoli ni potrebno. Vzamete obstoječi odprti model in ga povežete z vašimi podatki na enega od dveh načinov:
- Iskanje po lastnih dokumentih (RAG): model ob vsakem vprašanju dobi ustrezne odlomke iz vaših pravilnikov, pogodb ali tehnične dokumentacije. Znanje ostane v vaši bazi, model ga le bere.
- Dodatno učenje (fine-tuning): model prilagodite na vaših primerih, na primer na tisočih že pravilno razvrščenih računih. To pride na vrsto, ko ima naloga stalno obliko in je dovolj zgledov.
Za večino podjetij je prvi korak RAG, saj je cenejši, preglednejši in ga lažje posodabljate.
Zakaj se slovenska podjetja odločajo za lasten model
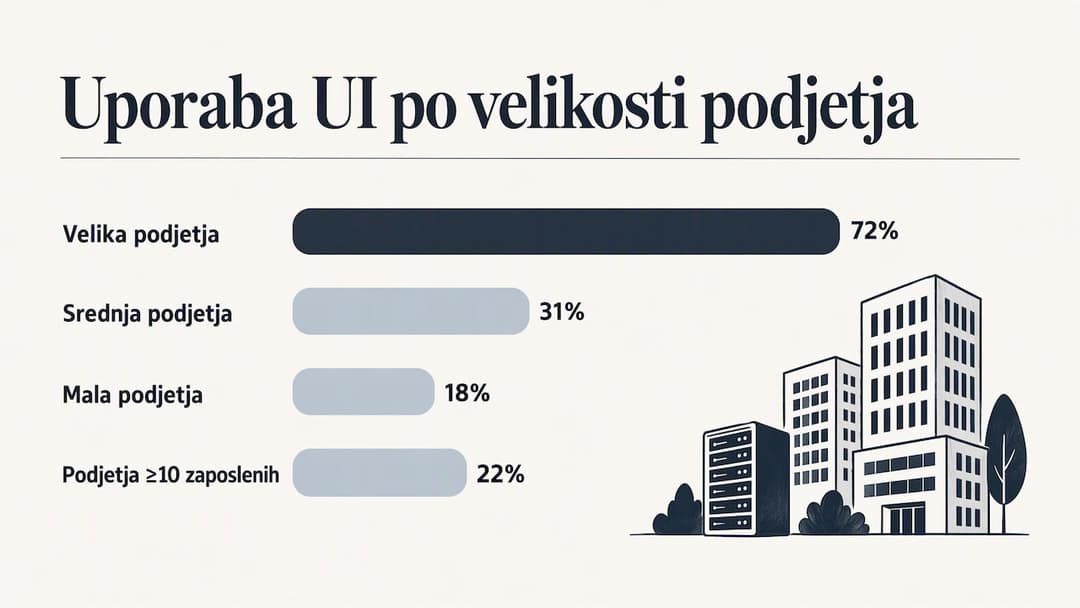
Umetna inteligenca se v slovenskih podjetjih hitro širi, a neenakomerno. Po podatkih SURS je v letu 2025 tehnologije umetne inteligence uporabljalo 22 % podjetij z vsaj 10 zaposlenimi. Razlike po velikosti so velike: 72 % velikih, 31 % srednje velikih in 18 % malih podjetij. Med podjetji, ki UI še ne uporabljajo, jih 69 % kot oviro navaja pomanjkanje strokovnega znanja, 42 % pa v njej ne vidi prednosti.
Prav pri velikih in srednjih podjetjih se vprašanje zasebnosti postavi najhitreje. Razlogi so konkretni:
- Zaupni podatki. Cenovni pogoji kupcev, recepture v prehranski industriji, podatki kliničnih študij ali tehnološki postopki niso podatki, ki bi jih pošiljali v javni klepetalnik.
- Nadzor nad dnevniki. Pri zasebnem modelu veste, kje so shranjeni pozivi in odgovori, kdo jih vidi in kdaj se izbrišejo.
- Predvidljivi stroški. Pri velikem in stalnem obsegu, na primer pri tisočih dokumentih na dan, je fiksna infrastruktura pogosto lažje obvladljiva kot plačilo po porabi.
- Povezava z internimi sistemi. Model, ki teče v vašem omrežju, lažje in varneje dostopa do ERP, MES ali sistema za upravljanje dokumentov.
- Neodvisnost od ponudnika. Odprti model lahko zamenjate z novejšim, ne da bi spremenili celoten sistem.
Raziskava GEM Slovenija kaže, da podjetniki z najvišjimi rastnimi ambicijami umetno inteligenco vidijo kot dejavnik konkurenčnosti. Za vse ostale velja preprosto pravilo: dokler projekt ne pokaže koristi na enem procesu, ga ni smiselno širiti.
Pravni okvir: GDPR, AI Act in odgovornost podjetja
Zasebni model ne pomeni, da ste samodejno skladni z zakonodajo. Pomeni le, da imate nadzor, s katerim skladnost lažje dokažete.
GDPR velja ne glede na to, ali model teče v oblaku ali v kleti. Ko model obdeluje osebne podatke zaposlenih, kupcev ali pacientov, morate poznati namen obdelave, omejiti dostop, določiti rok hrambe in poskrbeti za varnost. Načeli vgrajenega in privzetega varstva podatkov pomenita, da o anonimizaciji, psevdonimizaciji in pravicah dostopa odločite pri načrtovanju, ne po uvedbi. Če model obdeluje posebne vrste podatkov, na primer zdravstvene, se pred uvedbo posvetujte s svojo pooblaščeno osebo za varstvo podatkov.
Akt o umetni inteligenci, Uredba (EU) 2024/1689, loči med ponudniki sistemov UI in uvajalci, torej podjetji, ki sistem uporabljajo pri svojem delu. Podjetje, ki zasebni model vgradi v svoj proces, je praviloma uvajalec, v nekaterih primerih pa lahko prevzame tudi vlogo ponudnika. Obveznosti so odvisne od namena uporabe. Za sisteme visokega tveganja uredba zahteva sistem obvladovanja tveganj, ki se izvaja ves življenjski cikel sistema. Zajem podatkov z računov ni v isti kategoriji kot sistem, ki ocenjuje kandidate za zaposlitev. Kateri kategoriji pripada vaš primer, preverite s pravnikom, specializiranim za IT in varstvo podatkov, preden sistem zaženete v produkciji.
Pomaga, če ločite dve vrsti vsebin. Interni podatki, kot so pogodbe, naročila in recepture, morajo ostati v vašem okolju. Javne vsebine, kot so spletna stran, katalog in tehnični opisi izdelkov, pa so namenjene temu, da jih najdejo tudi javni generativni sistemi. Kako ti sistemi izbirajo vire, ki jih citirajo, pojasnjuje vodnik o optimizaciji vsebin za generativne iskalnike. Jasna meja med obema svetovoma je dober prvi korak interne politike rabe UI: zaposleni vedo, kaj sme v javno orodje in kaj gre samo skozi zasebni model.
Kaj potrebujete za delujoč zasebni LLM
Zasebni model ima tri plasti: strojno opremo, programski sklad in ljudi. Projekti se najpogosteje zataknejo pri tretji.
Strojna oprema: računajte s sočasnostjo
Pomnilnik grafične kartice (VRAM) mora sprejeti uteži modela. Groba računica: pri 16-bitni natančnosti vsak parameter zasede približno 2 bajta, pri 4-bitni kvantizaciji približno pol bajta. Model z 8 milijardami parametrov tako potrebuje okoli 16 GB oziroma okoli 4 do 5 GB, model s 70 milijardami parametrov pa okoli 140 GB oziroma okoli 35 do 40 GB, samo za uteži.
To pa je šele začetek. Vsak uporabnik in vsak dolg dokument zasedeta dodaten pomnilnik za t. i. KV-predpomnilnik, v katerem model hrani kontekst pogovora. Če ga ne načrtujete, sistem deluje hitro, ko ga preizkuša en človek, in se upočasni, ko ga zjutraj odpre petdeset referentov. Zato pri dimenzioniranju vprašajte:
- Koliko ljudi ali avtomatiziranih procesov bo model uporabljalo hkrati v najbolj obremenjeni uri?
- Kako dolgi so vhodi? Enostranski račun in 80-stranska pogodba nista enaka obremenitev.
- Ali lahko paketne naloge, na primer nočno obdelavo arhiva, premaknete izven delovnega časa?
- Kakšen odzivni čas je sprejemljiv: sekunda v klepetu ali nekaj minut pri obdelavi serije dokumentov?
Programski sklad
Za produkcijo ne zadošča, da model zaženete na prenosniku. Potrebujete:
- Inferenčni strežnik, ki model učinkovito streže več uporabnikom. Odprtokodni vLLM je razširjena izbira: z neprekinjenim paketnim obdelovanjem zahtev in učinkovitim upravljanjem pomnilnika bolje izkoristi grafično kartico ter ponuja vmesnik, združljiv z OpenAI API.
- Prehod API z avtentikacijo, omejitvami in beleženjem, da vaše aplikacije model kličejo na enoten način.
- Iskalno plast za RAG: vektorsko bazo, ki indeksira vaše dokumente in spoštuje pravice dostopa. Referent iz nabave ne sme prek modela dobiti plačnih list.
- Nadzor in sledljivost: spremljanje odzivnih časov, napak, porabe in kakovosti odgovorov.
- Integracije z ERP, MES, sistemom za dokumente in e-pošto. Tu nastane poslovna vrednost.
Ljudje in varnost
ENISA v poročilu o kibernetski varnosti umetne inteligence poudarja, da mora biti varnost vgrajena v celoten življenjski cikel sistema UI, ne dodana na koncu. Za zasebni LLM to pomeni zaščito pred vrivanjem ukazov (prompt injection) prek dokumentov, nadzor dostopa do podatkov, posodabljanje modela in programske opreme ter redno preverjanje kakovosti.
Upravljanje strežnika ni isto kot upravljanje modela. Nekdo mora spremljati, ali model še pravilno razvršča dokumente, ko dobavitelj spremeni obliko računa, nekdo mora preizkusiti novo različico modela, preden zamenja staro, in nekdo mora odgovarjati uporabnikom. Če te vloge v podjetju nimate, jo načrtujte pri zunanjem partnerju že pred nakupom strojne opreme.
Uvedba v šestih korakih
- Izberite en proces z jasno metriko. Na primer čas od prejema naročila do vnosa v ERP ali delež napak pri ročnem vnosu. Splošni cilj “uvesti UI” ni metrika.
- Razvrstite podatke. Kateri so osebni, kateri poslovna skrivnost in kateri javni? To določi postavitev: on-prem, zasebni oblak ali kombinacijo.
- Preizkusite več odprtih modelov na svojih primerih. Zberite nekaj sto resničnih dokumentov s pravilnimi rezultati in merite natančnost. Pri slovenskih dokumentih se modeli med seboj opazno razlikujejo.
- Postavite pilot v zasebnem oblaku. Tako izmerite dejansko obremenitev in sočasnost, preden kupite strojno opremo.
- Povežite model s procesom. Rezultat mora pristati v ERP ali MES, z jasnim pravilom, kdaj človek preveri izjemo.
- Načrtujte delovanje po uvedbi. Nadzor, posodobitve, varnostne popravke, merjenje kakovosti in podporo uporabnikom. Ta del traja dlje kot sam projekt.
Kje zasebni model prinese največ
Najboljši primeri imajo skupno točko: veliko ponavljajočega se dela z besedilom, ki ga danes opravljajo ljudje, in podatke, ki morajo ostati v hiši.
- Obdelava naročil in računov v distribuciji. Naročila prihajajo po e-pošti, v PDF-ju, kot skeni ali Excelove tabele. Model prebere dokument, prepozna kupca, artikle in količine, preveri podatke z matičnimi podatki v ERP in pripravi vnos. Referent potrdi le izjeme.
- Prehranska industrija. Specifikacije dobaviteljev, certifikati, deklaracije alergenov in reklamacije so dokumenti, kjer je napaka draga, recepture pa poslovna skrivnost.
- Proizvodnja in planiranje. Model povzame zapise izmen, poišče vzroke zastojev v poročilih vzdrževanja in planerju odgovori na vprašanja o stanju naročil, povezan z MES.
- Logistika. Dobavnice, transportni nalogi in potrdila o dostavi se prenesejo v sistem brez ročnega pretipkavanja, kar zmanjša napake pri naročilih.
- Farmacija in klinične študije. Strogo regulirani podatki, kjer sta sledljivost in nadzor dostopa obvezna.
Naš pogled: model je orodje, proces je cilj
Pri projektih avtomatizacije vidimo isti vzorec: podjetje začne z vprašanjem, kateri model izbrati, odgovor pa se skriva v procesu. Zasebni jezikovni model je dober gradnik, ko podatki ne smejo zapustiti hiše. Sam po sebi pa ne skrajša obdelave naročil. To naredi šele sistem, ki dokument prebere, razvrsti, preveri in prenese v ERP, ter človek, ki ve, kdaj mora poseči.
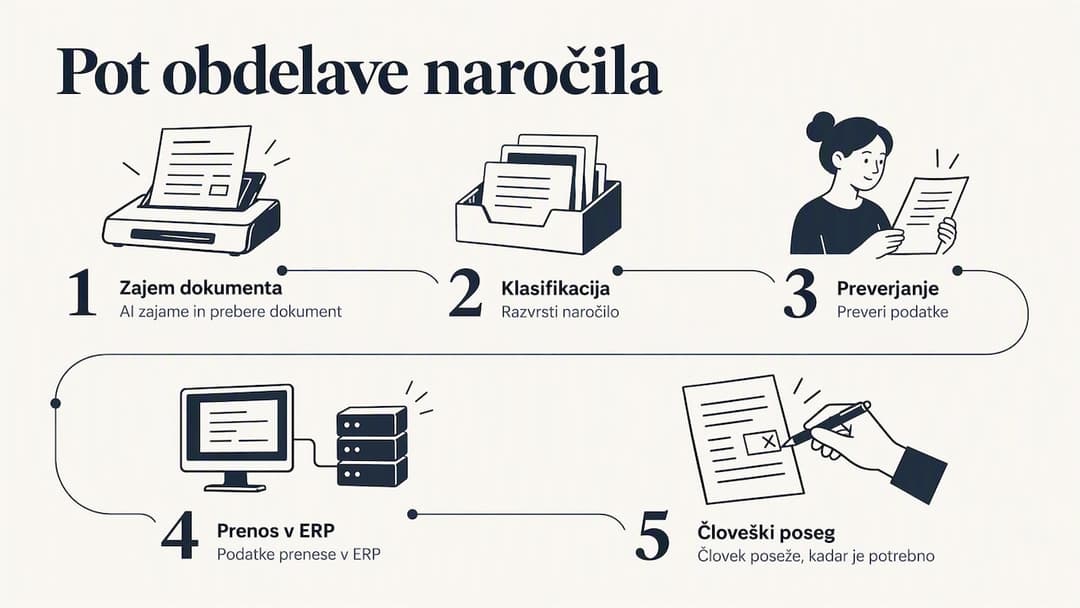
Zato vsak projekt začnemo pri procesu in meritvi. Pri enem od naših projektov je avtomatizacija skrajšala čas obdelave naročil za 68 %, naložba pa se je povrnila v 8 do 10 mesecih. Ta rezultat ni prišel iz izbire modela, temveč iz povezave AI zajema, klasifikacije in preverjanja z obstoječimi sistemi naročnika.
Drugo spoznanje: tveganje uvedbe je najmanjše, ko projekt vodijo ljudje, ki poznajo panogo. Napake pri recepturi, serijski številki ali dobavnem roku se v prehrani, farmaciji in betonarni kažejo zelo različno. Zato pri nas sodelujejo strokovno specializirane ekipe, ki rešitev prilagodijo procesom naročnika, in po uvedbi ostanemo ob strani. Model, ki ga nihče ne spremlja, čez pol leta dela slabše kot na dan zagona.
Naš nasvet je preprost: izberite en proces, izmerite izhodišče, pokažite rezultat v nekaj mesecih in šele nato širite.
— Martin
Avtomatizacija z AI, ki deluje v vaših sistemih
Pri NovaCore Group gradimo rešitve, ki umetno inteligenco postavijo tja, kjer nastaja delo: avtomatizacija dokumentov (AI zajem, klasifikacija, preverjanje in prenos v ERP), upravljanje proizvodnje (planiranje, razporejanje, naročila, transport in sledenje dostavam) ter prediktivno planiranje (povezava z ERP in MES, napovedovanje povpraševanja in odkrivanje ozkih grl). Za farmacijo in betonske obrate razvijamo končna produkta Vilintra in Concreete.
→ Preglejte naše rešitve in se dogovorite za pogovor o vašem procesu
Pogosta vprašanja
Ali je zasebni LLM dovolj dober v slovenščini?
Za ozke naloge, kot so zajem podatkov, razvrščanje in povzemanje, so sodobni odprti modeli praviloma uporabni tudi v slovenščini. Razlike med modeli so pri našem jeziku opazne, zato kakovost vedno preizkusite na lastnih dokumentih. Natančnost pogosto bolj izboljša dobra iskalna plast in jasna navodila kot večji model.
Koliko stane zasebni LLM?
Strošek je sestavljen iz strojne opreme ali najema grafičnih strežnikov, integracij z obstoječimi sistemi in delovanja po uvedbi. Največji vpliv imata velikost modela in število sočasnih uporabnikov. Smiselno je začeti s pilotom v zasebnem oblaku in o nakupu strojne opreme odločati na podlagi izmerjene obremenitve.
Ali moramo model učiti na svojih podatkih?
Večinoma ne. Večina podjetij začne z iskanjem po lastnih dokumentih (RAG), kjer model ob vprašanju dobi ustrezne odlomke in podatkov ne vgradi vase. Dodatno učenje ima smisel pri stalnih, ponavljajočih se nalogah z veliko kakovostnih primerov.
Ali nas zasebni model naredi skladne z GDPR in AI Act?
Ne samodejno. Zasebna postavitev vam da nadzor nad podatki in dnevniki, skladnost pa zahteva še določen namen obdelave, pravice dostopa, roke hrambe in oceno tveganj. Pred produkcijo se posvetujte s pooblaščeno osebo za varstvo podatkov in pravnikom za IT.