
Data lake ali data warehouse: razlike in kdaj izbrati lakehouse
Data lake ali data warehouse: razlike in kdaj izbrati lakehouse
Podatkovno skladišče (data warehouse) hrani urejene, preverjene podatke, pripravljene za poročila in nadzorne plošče. Podatkovno jezero (data lake) hrani surove podatke v izvirni obliki, od tabel iz ERP do PDF-jev, slik in signalov senzorjev, strukturo pa jim določite šele ob analizi. Skladišče izberete, ko potrebujete zanesljiva poročila za vodstvo. Jezero izberete, ko želite graditi modele strojnega učenja na velikih in raznolikih podatkih. Če potrebujete oboje, je danes najpogostejši odgovor podatkovni lakehouse, ki združuje poceni shranjevanje jezera z redom in hitrostjo skladišča.
V nadaljevanju razložimo razlike, jih postavimo v primerjalno tabelo, pokažemo, kako izbrati, in kaj pri tem zahteva slovenska zakonodaja o varstvu osebnih podatkov.
Novacore-groupPretvorite podatke v učinkovitejše proceseNovaCore Group avtomatizira delovne procese z umetno inteligenco ter pomaga optimizirati upravljanje dokumentov, proizvodnjo in načrtovanje.Spoznajte NovaCore GroupTL;DR
- Podatkovno skladišče hrani strukturirane, očiščene podatke po vnaprej določeni shemi (schema-on-write). Je najboljša izbira za poročanje in poslovno inteligenco (BI).
- Podatkovno jezero hrani surove podatke vseh vrst, strukturo jim določi šele poizvedba (schema-on-read). Je najboljša izbira za podatkovno znanost in umetno inteligenco.
- Lakehouse združi oboje: shranjevanje jezera, nad njim pa transakcije, sheme in upravljanje metapodatkov, kot jih pozna skladišče.
- Jezero brez kataloga in pravil hitro postane podatkovno močvirje, kjer podatkov ni mogoče najti ali jim zaupati.
- V Sloveniji morate že pri načrtovanju upoštevati GDPR in ZVOP-2, vključno z dnevniki obdelave, kjer jih zakon zahteva.
Kazalo
- Kaj je podatkovno skladišče
- Kaj je podatkovno jezero
- Primerjava na enem mestu
- Data lakehouse: zakaj ga omenja vsak sodoben projekt
- Kako izbrati: pet vprašanj pred odločitvijo
- Kako to izgleda v proizvodnji, logistiki in prehrani
- Varstvo podatkov: ZVOP-2 in GDPR že pri zasnovi
- Pogoste napake, ki stanejo največ
- Naš pogled
- Od podatkov do avtomatiziranih procesov
- Pogosta vprašanja
- Viri
Kaj je podatkovno skladišče
Podatkovno skladišče je relacijski repozitorij za skrbno urejene, strukturirane podatke, optimiziran za standardno poslovno poročanje. Podatke iz ERP, CRM, sistema za upravljanje skladišča in drugih virov najprej očistite, preoblikujete in uskladite s shemo, šele nato jih naložite. Temu pravimo schema-on-write: struktura je znana, preden zapišete prvo vrstico. Pregled po definiciji iz oblačnega slovarja poudarja prav to razliko: skladišče strukturo določi vnaprej, jezero šele ob analizi.
Kaj s tem pridobite:
- Eno resnico za vodstvo. Prihodek, marža, OEE ali delež pravočasnih dostav se izračunajo povsod enako.
- Hitre poizvedbe. Ker so podatki že urejeni, nadzorna plošča odgovori v sekundah.
- Nadzor in revizijsko sled. Jasno je, od kod podatek prihaja in kdo ga sme videti.
Kje se zatakne: vsak nov vir podatkov pomeni delo na shemi in procesu nalaganja. Nestrukturiranih podatkov, kot so skenirani dobavnice, fotografije napak ali dnevniki strojev, skladišče ne obvlada dobro. Shranjevanje velikih količin je praviloma dražje kot v jezeru.
Kaj je podatkovno jezero
Podatkovno jezero je osrednji repozitorij, ki sprejme velike količine podatkov v izvirni obliki: strukturirane tabele, polstrukturirane datoteke JSON ali XML in povsem nestrukturirane vsebine, kot so dokumenti, slike in zvok. Podatke najprej shranite, strukturo pa jim določite, ko jih berete. Temu pravimo schema-on-read.
Pregledni znanstveni članek o skladiščih in jezerih v sodobnem upravljanju podatkov razliko opiše jasno: skladišče hrani podatke, obdelane za določen namen, jezero pa je velik bazen podatkov, katerih namen še ni določen.
Kaj s tem pridobite:
- Prilagodljivost. Shranite danes, odločite se jutri. Ko se pojavi novo vprašanje, podatki že čakajo.
- Nižji strošek na terabajt. Jezera praviloma temeljijo na objektni shrambi, ki je cenejša od relacijskih baz.
- Gorivo za umetno inteligenco. Modeli za napovedovanje povpraševanja ali odkrivanje napak potrebujejo surove, podrobne podatke, ne povzetkov.
Kje se zatakne: brez upravljanja jezero hitro propade. Arhitekturni pregled na tehničnem blogu velikega oblačnega ponudnika opozarja, da jezero brez kataloga, sledenja izvoru in samodejnega upravljanja metapodatkov postane “podatkovno močvirje”: podatki obstajajo, a jih nihče ne najde, ne razume in jim ne zaupa.
Primerjava na enem mestu
| Merilo | Podatkovno skladišče | Podatkovno jezero | Lakehouse |
|---|---|---|---|
| Vrsta podatkov | Strukturirani | Vse vrste, tudi nestrukturirani | Vse vrste |
| Shema | Vnaprej (schema-on-write) | Ob branju (schema-on-read) | Uveljavljena nad odprtimi datotekami |
| Glavni uporabniki | Analitiki, kontroling, vodstvo | Podatkovni znanstveniki, inženirji | Oboji na istih podatkih |
| Tipična raba | BI, poročila, KPI | Strojno učenje, raziskovanje, arhiv | BI in AI brez podvajanja |
| Strošek shranjevanja | Višji | Nižji | Nižji |
| Hitrost poizvedb | Visoka | Odvisna od priprave | Visoka ob pravi zasnovi |
| Kakovost podatkov | Visoka, preverjena ob vnosu | Odvisna od upravljanja | Transakcije in sheme jo varujejo |
| Glavno tveganje | Togost, počasno dodajanje virov | Podatkovno močvirje | Zahtevnejša selitev in uskladitev |
Data lakehouse: zakaj ga omenja vsak sodoben projekt
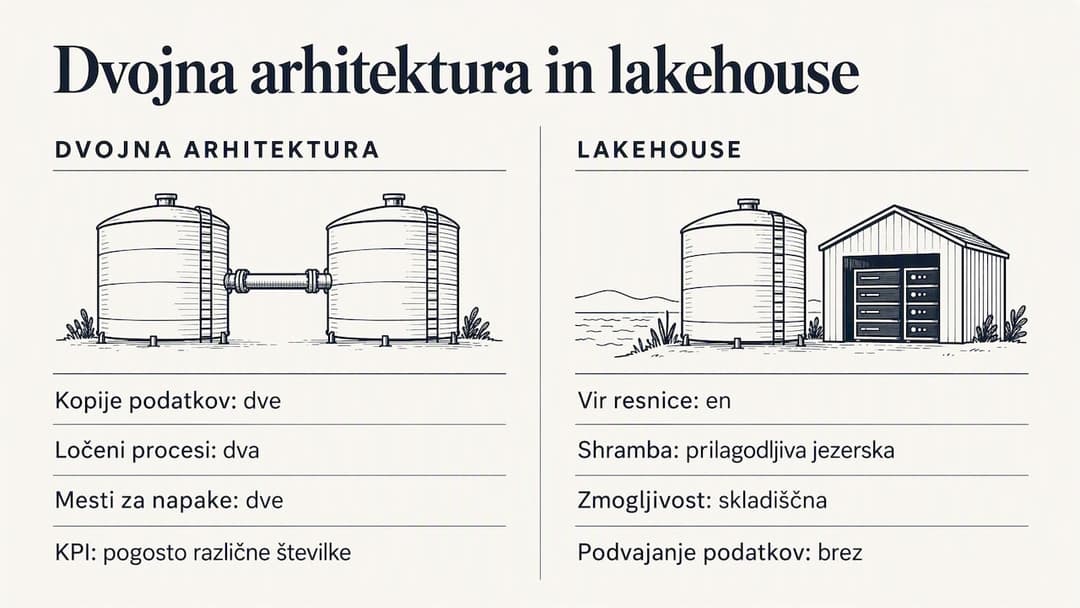
Lakehouse (v slovenski terminologiji ga ena od uradnih strani ponudnika programske opreme imenuje “skladiščno jezero podatkov”) je hibridna arhitektura. Podatke hrani v poceni objektni shrambi kot jezero, nad njimi pa uporablja načela podatkovnih baz: transakcije ACID, uveljavljanje sheme in upravljanje metapodatkov. Razlaga koncepta lakehouse poudarja ključno prednost: orodja za AI, strojno učenje in BI delajo na enem viru resnice, brez podvajanja podatkov med ločenimi sistemi.
Zakaj je to pomembno v praksi? V klasični dvojni arhitekturi podatke najprej naložite v jezero, nato del kopirate v skladišče. Imate dve kopiji, dva procesa, dve mesti za napake in pogosto dve različni številki za isti KPI. Pregled arhitekture lakehouse ga opiše kot rešitev, ki z združitvijo ločenih podatkovnih otokov ponudi prilagodljivo shranjevanje jezera in zmogljivost skladišča.
Tehnično lakehouse omogočajo odprti formati tabel, ki nad navadnimi datotekami vodijo transakcijski dnevnik. Tako lahko več procesov hkrati piše in bere, ne da bi kdo videl napol zapisane podatke, in lahko se vrnete na prejšnje stanje tabele.
Lakehouse pa ni čarobna paličica. Izkušnje inženirjev, ki so opisali selitev iz skladišča v lakehouse, kažejo, da postavitev infrastrukture ni najtežji del. Težje je dokazati, da nova platforma daje enake številke in enako zanesljivost kot staro skladišče. To pomeni vzporedno delovanje, sistematično usklajevanje rezultatov in jasen načrt za vrnitev nazaj.
Kako izbrati: pet vprašanj pred odločitvijo
Arhitektura sledi namenu in zrelosti podatkov, ne trendu. Pred odločitvijo si odgovorite na teh pet vprašanj.
- Kaj želite z podatki narediti v naslednjih 12 mesecih? Če so to mesečna poročila, KPI in nadzorne plošče, začnite s skladiščem. Če so to napovedi povpraševanja, prediktivno vzdrževanje ali avtomatsko branje dokumentov, potrebujete surove podatke, torej jezero ali lakehouse.
- Kakšne podatke imate? Pretežno tabele iz ERP in MES vodijo k skladišču. Veliko skeniranih dokumentov, e-pošte, slik ali senzorskih podatkov vodi k jezeru ali lakehousu.
- Kdo bo podatke uporabljal? Ekipa, ki dela v SQL in Excelu, bo najhitreje produktivna s skladiščem. Ekipa s podatkovnimi znanstveniki potrebuje dostop do surovih podatkov.
- Kako zreli so vaši procesi? Če isti izdelek v dveh sistemih nosi različni šifri, vam nobena arhitektura ne bo pomagala, dokler ne uredite matičnih podatkov.
- Kdo bo sistem vzdrževal? Jezero in lakehouse zahtevata stalno skrb za katalog, pravice in kakovost. Brez lastnika podatkov se vsaka arhitektura postara v nekaj mesecih.
Praktično pravilo: srednje veliko podjetje, ki šele gradi poročanje, naj začne majhno, z jasnim ciljem in arhitekturo, ki dovoljuje rast. Lakehouse je smiseln, ko že veste, da boste poleg poročil gradili tudi modele umetne inteligence.
Kako to izgleda v proizvodnji, logistiki in prehrani
Abstraktne razlike postanejo jasne na konkretnih primerih iz panog, ki so v Sloveniji močne.
Proizvodnja
Planer potrebuje zanesljiv pregled zasedenosti linij, zalog in zamud. To je klasična naloga skladišča s podatki iz ERP in MES. Ko pa želite napovedati, kje bo jutri nastalo ozko grlo, potrebujete podrobne časovne vrste iz strojev, zgodovino zastojev in podatke o naročilih. To so podatki, ki sodijo v jezero ali lakehouse.
Logistika in distribucija
Napake pri naročilih pogosto nastanejo že pri vnosu: naročilnice prihajajo po e-pošti kot PDF, v različnih oblikah, in nekdo jih ročno prepisuje. Surove dokumente je smiselno hraniti v jezeru, izluščene in preverjene podatke pa v strukturirani obliki prenesti v ERP in poročanje. Sledenje dostavam in GPS podatki voznikov ustvarjajo velike količine polstrukturiranih podatkov, ki jih skladišče težko sprejme v izvirni obliki.
Prehrambena industrija
Sledljivost serij, temperature v hladni verigi in roki uporabnosti zahtevajo oboje: zanesljiva poročila za presoje in kupce ter podrobne zapise senzorjev za analizo odstopanj. Tu se lakehouse pogosto izkaže, ker ista temperaturna serija služi tako revizijskemu poročilu kot modelu, ki napove, kje bo hladna veriga popustila.
Varstvo podatkov: ZVOP-2 in GDPR že pri zasnovi
Podatkovno jezero zbira vse, in prav to je pravno tveganje. Če vanj brez premisleka pretakate podatke o zaposlenih, voznikih ali pacientih, lahko hitro kršite načelo najmanjšega obsega podatkov.
V Sloveniji poleg splošne uredbe GDPR velja Zakon o varstvu osebnih podatkov (ZVOP-2), ki se uporablja od 26. januarja 2023 in je nadomestil ZVOP-1. Za arhitekturo podatkov so ključne tri stvari:
- Najmanjši obseg podatkov. Zbirajte samo, kar za namen res potrebujete. Če spremljate gibanje viličarjev zaradi varnosti, ne potrebujete biometričnih podatkov voznikov.
- Roki hrambe. Določite jih ob zasnovi in jih v sistemu tudi samodejno izvajajte. Jezero, ki hrani vse za vedno, je v nasprotju s tem načelom.
- Dnevniki obdelave. Informacijski pooblaščenec v mnenju o obveznosti vodenja dnevnika obdelave obravnava obveznosti iz 22. člena ZVOP-2. Po povzetku zakona se dnevniki pri obsežni obdelavi posebnih vrst podatkov ali sistematičnem spremljanju hranijo najmanj dve leti, odvisno od ocene tveganja tudi dlje.
Naknadno “krpanje” skladnosti v delujočo arhitekturo je drago in organizacijsko naporno. Če obdelujete zdravstvene podatke (na primer v kliničnih študijah) ali sistematično spremljate zaposlene, se pred zasnovo jezera posvetujte s svojo pooblaščeno osebo za varstvo podatkov in preverite, ali vaš primer spada pod obvezno vodenje dnevnikov.
Pogoste napake, ki stanejo največ
- Jezero kot odlagališče. Vse naložite, nič ne popišete. Po letu dni nihče ne ve, katera datoteka je zadnja različica.
- Skladišče za vse. Vanj silite nestrukturirane podatke in zanje gradite vedno nove sheme. Projekt se vleče, stroški rastejo.
- Tehnologija pred vprašanjem. Izberete platformo, preden veste, katera poslovna odločitev bo od nje odvisna.
- Slabi podatki na vhodu. Ročni vnosi z napakami se prenesejo v vsako arhitekturo. Avtomatski zajem in preverjanje dokumentov odpravita težavo pri izvoru.
- Selitev brez uskladitve. Novo platformo vklopite, staro izklopite, številke pa se ne ujemajo. Zaupanje uporabnikov izgubite v enem tednu.
Naš pogled
V projektih avtomatizacije vidimo vedno isti vzorec: vprašanje “jezero ali skladišče” se pojavi prezgodaj. Podjetja najprej izbirajo platformo, šele nato ugotovijo, da so podatki na vhodu nezanesljivi. Naročilnice se prepisujejo ročno, šifre v ERP se ne ujemajo z MES, planerji pa svoje urnike vodijo v preglednicah.
Zato začnemo pri procesu, ne pri arhitekturi. Ko dokumente samodejno zajamemo, razvrstimo, preverimo in prenesemo v ERP, dobi vsaka podatkovna platforma čiste podatke. Ko je ERP povezan z MES, lahko gradimo prediktivno planiranje: napovedovanje povpraševanja, napredne urnike in odkrivanje ozkih grl. Takrat podatkovna arhitektura postane orodje, ne cilj.
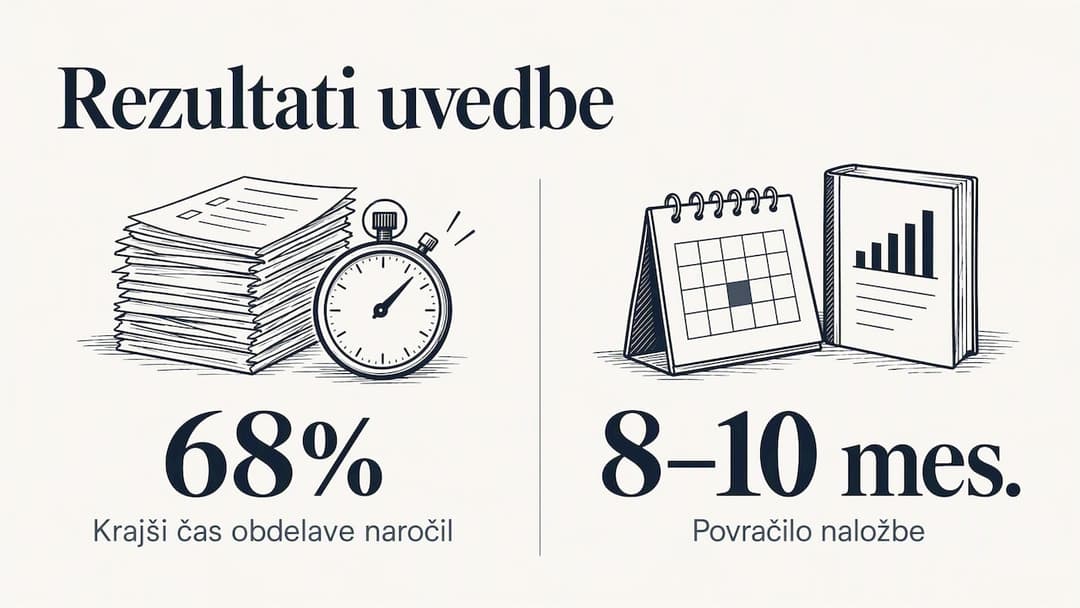
Rezultat šteje. Pri eni od uvedb smo čas obdelave naročil skrajšali za 68 odstotkov, naložba pa se je povrnila v 8 do 10 mesecih. Tega ni prinesla izbira med jezerom in skladiščem, temveč urejen tok podatkov od dokumenta do odločitve.
Ker naše ekipe združujejo znanje iz različnih panog, od farmacije do proizvodnje in logistike, vemo, da klinična študija, betonarna in hladna veriga ne potrebujejo enake rešitve. In ker ostanemo ob vas tudi po uvedbi, sistem raste skupaj z vašimi podatki.
— Martin
Od podatkov do avtomatiziranih procesov
V NovaCore Group gradimo AI rešitve, ki podatke spremenijo v delujoče procese:
- Avtomatizacija dokumentov: AI zajem, klasifikacija, preverjanje in prenos v ERP.
- Upravljanje proizvodnje: planiranje, razporejanje, upravljanje naročil in transporta, aplikacije za voznike in sledenje dostavam, povezano z ERP.
- Prediktivno planiranje: povezava z ERP in MES, napovedovanje povpraševanja, napredni urniki in odkrivanje ozkih grl.
Poglejte, kako to deluje v praksi, na primer pri platformi za logistiko hladne verige Frigologo ali programski opremi za upravljanje betonarn Concreete.
→ Preglejte naše rešitve in se dogovorite za pogovor
Pogosta vprašanja
Ali je podatkovno jezero vrsta podatkovne baze?
Ne v klasičnem pomenu. Podatkovna baza hrani podatke po strogi shemi in podpira transakcije, jezero pa je shramba datotek v izvirni obliki, običajno na objektni shrambi. Lakehouse nad jezero doda lastnosti baz, kot so transakcije in sheme.
Kako deluje arhitektura lakehouse?
Podatki so shranjeni v odprtih datotečnih formatih v poceni shrambi. Nad njimi sloj metapodatkov vodi transakcijski dnevnik, uveljavlja sheme in omogoča hitre poizvedbe. Tako BI orodja in modeli strojnega učenja berejo iste podatke brez kopiranja.
Ali so oblačna podatkovna skladišča isto kot podatkovno jezero?
Ne. Oblačno podatkovno skladišče je še vedno skladišče, le da teče kot storitev v oblaku z ločenim plačilom shranjevanja in računske moči. Številne takšne storitve danes znajo brati tudi datoteke iz jezera, zato je meja med kategorijami vse tanjša.
Kakšna je razlika med podatkovnim centrom in podatkovnim skladiščem?
Podatkovni center je fizična infrastruktura: stavba s strežniki, napajanjem in hlajenjem. Podatkovno skladišče je programska rešitev za analitiko, ki lahko teče v vašem podatkovnem centru ali v oblaku. Eno je prostor, drugo način organizacije podatkov.
Viri
- Microsoft Azure: What is a data lake? Data lake vs. warehouse
- MDPI: An Overview of Data Warehouse and Data Lake in Modern Enterprise Data Management
- AWS Big Data Blog: Navigating architectural choices for a lakehouse
- Microsoft: Kaj je skladiščno jezero podatkov?
- AWS: What is a data lakehouse?
- Google Cloud: What is a data lakehouse?
- DEV Community: Warehouse to lakehouse migration
- RewardSet: Slovenian Personal Data Protection Act (ZVOP-2)
- Informacijski pooblaščenec: Obveznost vodenja dnevnika obdelave